1 簡介
從「大海撈針」到「目錄導航」
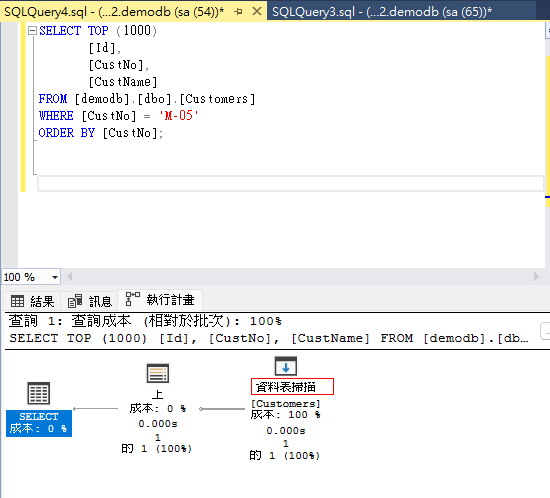
在 SQL Server 的世界裡,沒有建立索引的資料表就像一個雜亂無章的儲藏室(稱為 Heap,堆疊)。因為裡面的物品(資料)沒有經過任何特定順序的排列,當你想找某件東西時,系統別無選擇,只能從頭到尾把每一件物品都翻一遍,這個翻箱倒櫃的過程就叫做 資料表掃描 (Table Scan)。當資料量極大時,這種做法會消耗大量的磁碟 I/O,讓效能徹底崩潰。
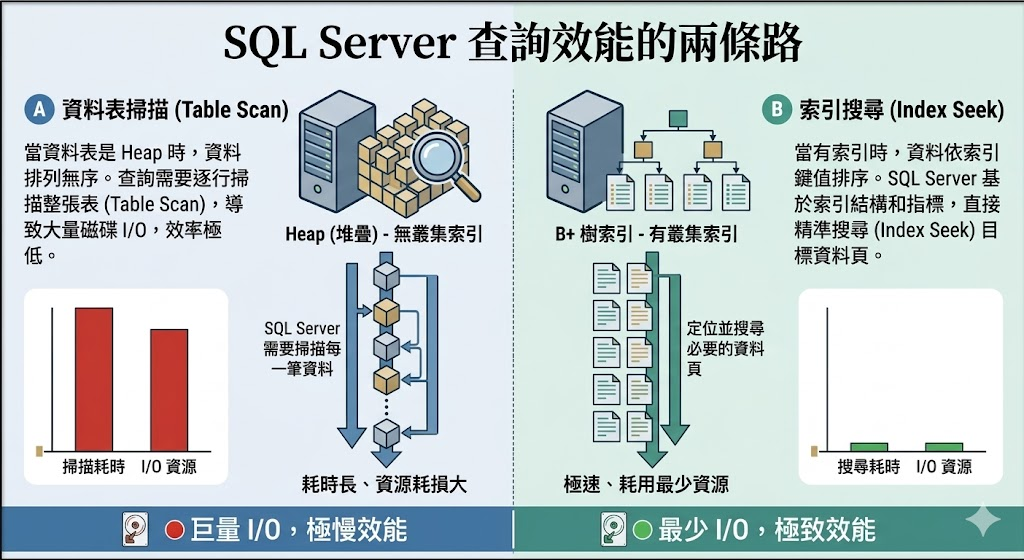
相反地,一旦你建立了索引,資料在儲存時就會乖乖依照索引的鍵值排好隊。此時的資料表就像一本編排精準的字典,SQL Server 不需要傻傻地從第一頁翻到最後一頁,而是直接透過「目錄(指標)」精準跳轉到特定的頁面,直接拿取你要的結果。這種精準打擊、只搜尋必要資料頁的操作,就叫做 索引搜尋 (Index Seek)。它是減少磁碟 I/O、拯救資料庫效能的終極利器。
索引作為提高 SQL server 查詢效能徑之一,通常來說也是最快看到效果,最有效的,所以在遇到資料庫查詢效能問題的時候往往是第一個出現在DBA或Developer腦海裏。正確置的索引能提高query查詢資料的效能(速度),減少query花費的資源。
當一個資料表(Table)没有叢集索引時,我們稱之為Heap(堆叠),堆疊資料表的資料不是按照資料新增的順序做排序,所以在查詢語法時 SQL server需要掃資料表裏的每一筆資料,這個動作就是資料表掃描(Table Scan) 。
當資料表有索引時,在資料存在Data page時就是依照索引的鍵值來排序並儲存。所以SQL Server 將基於該索引鍵值和結構來定位(透過指標)資料位置,簡單來說只發尋必要的資料頁,而這些資料頁已經包含使用者最終所需要的資料結果集,這樣的操作就稱為索引搜尋Index Seek。
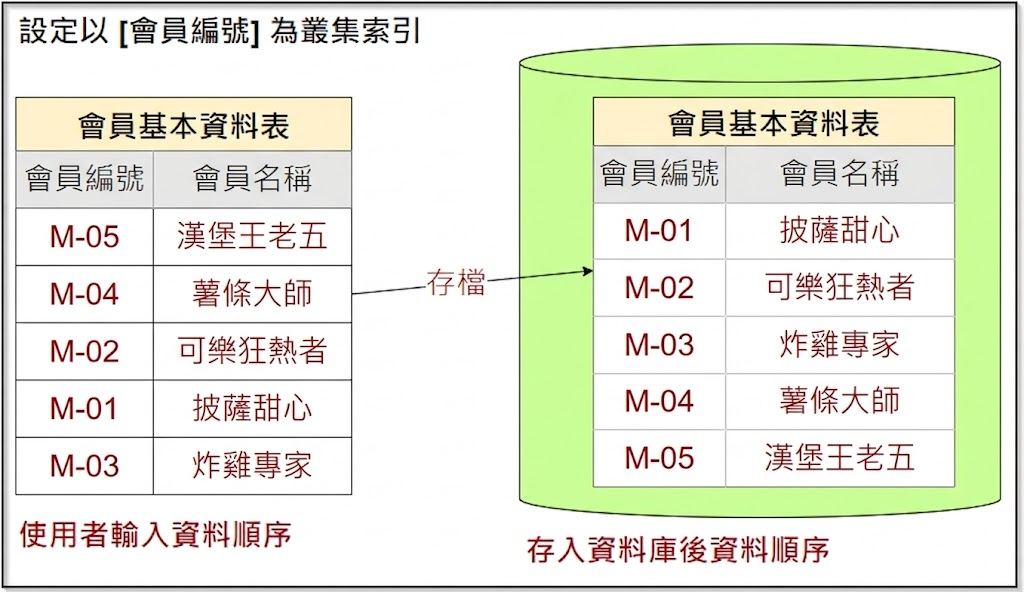
設定叢集索引存檔時的實際排序
如圖,使用者輸入資料時不會依照一定方式輸入,但只要指定客戶編號為叢集索引,存檔後,資料庫會依據我們指定的叢集索引鍵作好排序,這稱呼叢集索引。
2 建立範例表格資料(T-SQL)
開啟 SSMS 查詢視窗 執行以下指令:
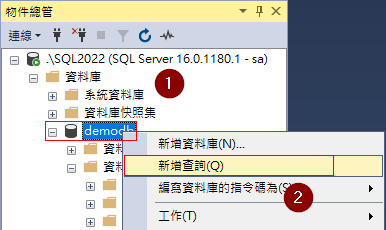
SQL 指令
建立客戶基本資料,客戶編號依照 (E、D、B、A、C) 一一輸入,並無依照順序性。
USE [demodb]
GO

DROP TABLE IF EXISTS [dbo].[Customers]
GO

SET ANSI_NULLS ON
GO
SET QUOTED_IDENTIFIER ON
GO
CREATE TABLE [dbo].[Customers](
	[Id] [int] IDENTITY(1,1) NOT NULL,
	[CustNo] [nvarchar](50) NULL,
	[CustName] [nvarchar](50) NULL,
 CONSTRAINT [PK_Customers] PRIMARY KEY CLUSTERED
(
	[Id] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON, OPTIMIZE_FOR_SEQUENTIAL_KEY = OFF) ON [PRIMARY]
) ON [PRIMARY]
GO
SET IDENTITY_INSERT [dbo].[Customers] ON
GO

INSERT [dbo].[Customers] ([Id], [CustNo], [CustName]) VALUES (1, N'E', N'大仁科技')
INSERT [dbo].[Customers] ([Id], [CustNo], [CustName]) VALUES (2, N'D', N'仁興科技')
INSERT [dbo].[Customers] ([Id], [CustNo], [CustName]) VALUES (3, N'B', N'天方科技')
INSERT [dbo].[Customers] ([Id], [CustNo], [CustName]) VALUES (4, N'A', N'誠華科技')
INSERT [dbo].[Customers] ([Id], [CustNo], [CustName]) VALUES (5, N'C', N'信方科技')
GO

SET IDENTITY_INSERT [dbo].[Customers] OFF
GO
執行結果
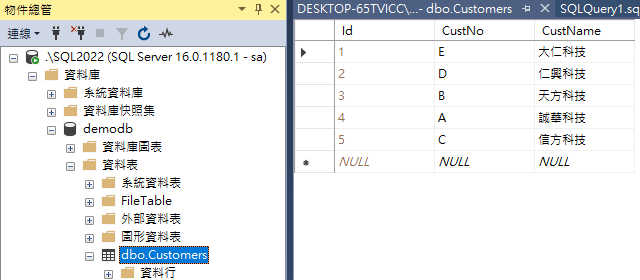
目前顯示的結果是沒有指定用資料行
CustNo為叢集索引的方式來顯示CustNo(E、D、B、A、C) 的資料。
接下來如何將CustNo欄位改成叢集索引:
- 選取資料表
dbo.Customers後,滑鼠右鍵點擊 設計
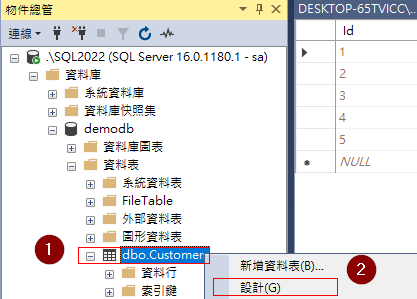
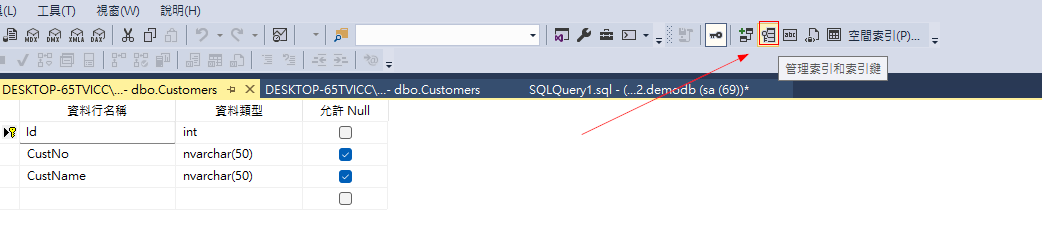
- 點選右上角 管理索引和索引鍵
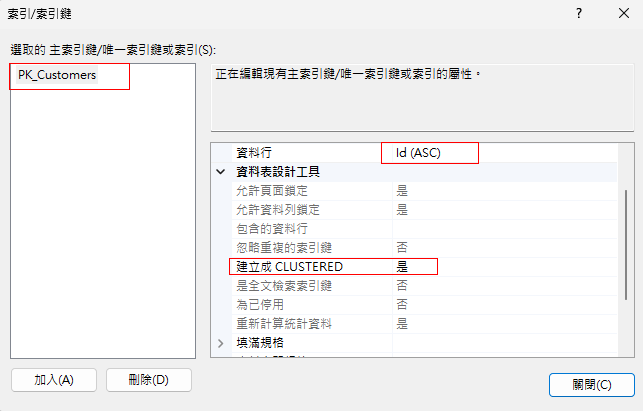
可以看到已經有主索引鍵PK_Customers,資料行是Id,並且已經建立成為CLUSTERED叢集索引,如下圖。
- 實務上是找出最常用到的欄位來作為叢集索引,這裡是
CustNo。 - 按下 加入 後會產生新索引鍵
IX_Customer,在按下右側 (3)
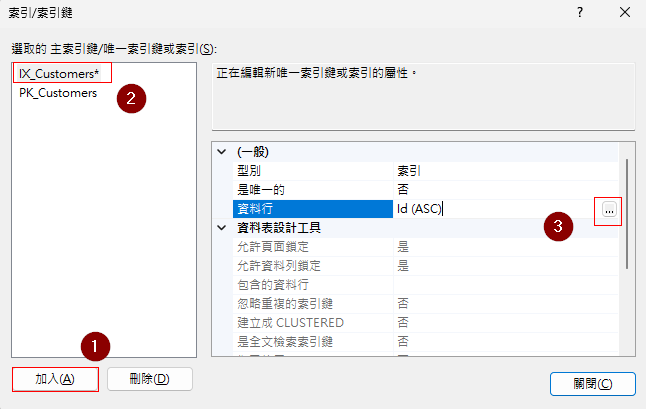
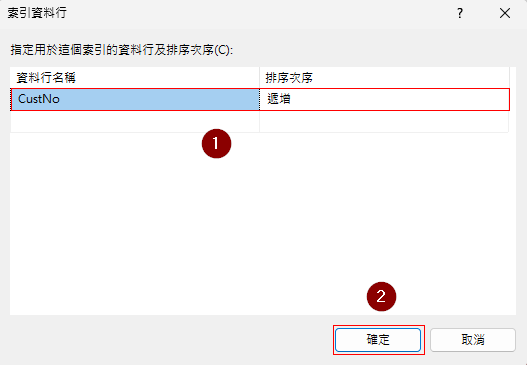
指定資料行CustNo作為排序的依據,排序方式選擇遞增。
IX_Customer Customer table’s Index
PK_Customer Customer’table’s Primary - 一個資料表只能有一個索引鍵當作為叢集索引,查詢時以這個資料行來排序,現在是
Id,如何把它換成CustNo,先將原本為叢集索引欄位的主索引(PK_Customers)Id,於建立成 CLUSTERED 上,改成否。
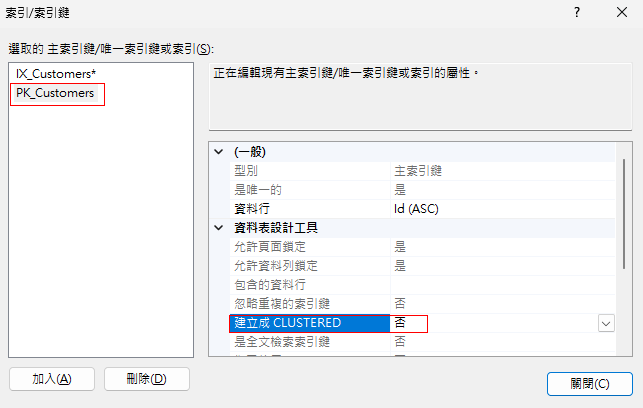
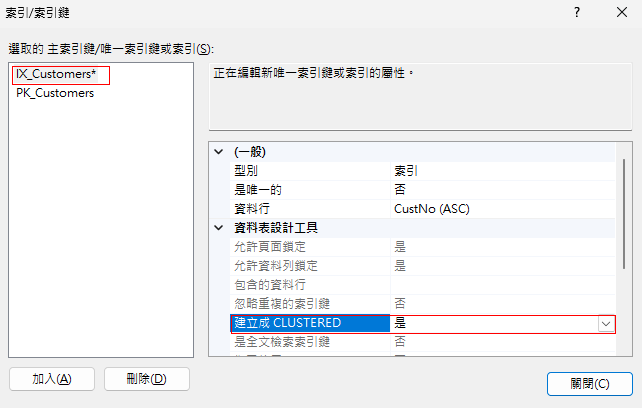
- 接著將新增的
IX_Customer*,資料行設為CustNo,,於建立成 CLUSTERED 上,改成是。
- 修改索引鍵原名稱:
IX_Customers*為IX_Customers_cno,解譯為以CustNo作為索引依據,以客戶編號來排序。
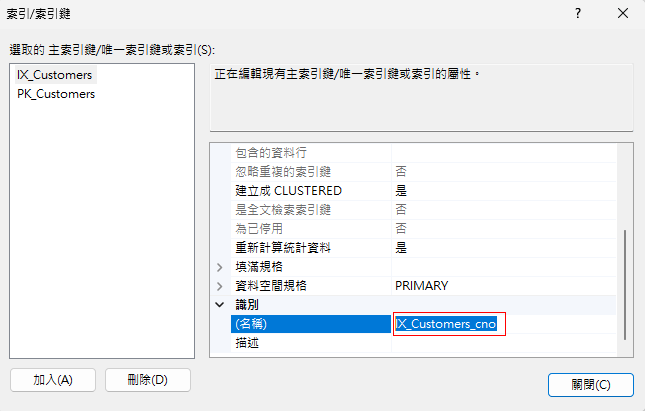
- 加入第三組索引
CustName,因為也可能被拿來查詢。- 按下 加入 後會產生新索引鍵
IX_Customer,在按下右側 (3)
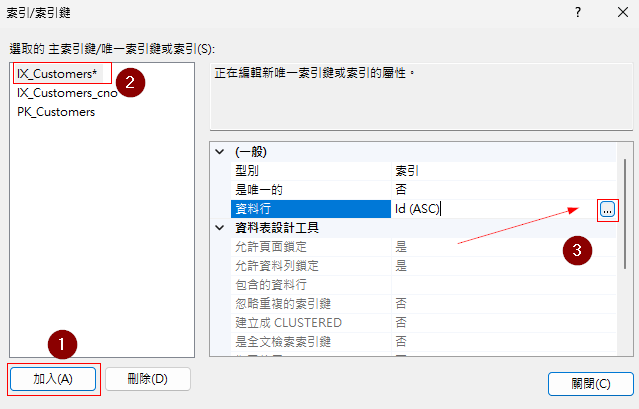
- 指定資料行
CustName作為排序的依據,排序方式選擇遞增。
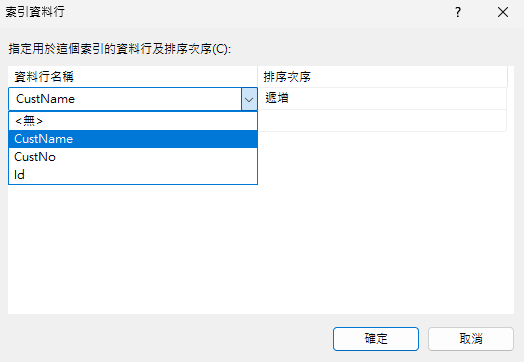
以CustName先作查詢,碰到客戶名稱同名稱在找下一個CustNo。
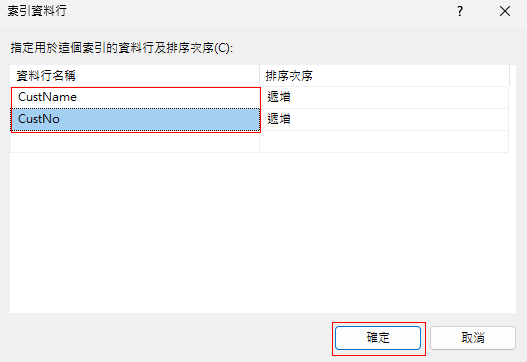
- 修改索引鍵原名稱:
IX_Customers*為IX_Customers_cno_cname,解譯為以CustNo作為索引依據,以客戶編號來排序。 - 到此不用在新增索引欄位,因為不會有其他欄位的重覆。
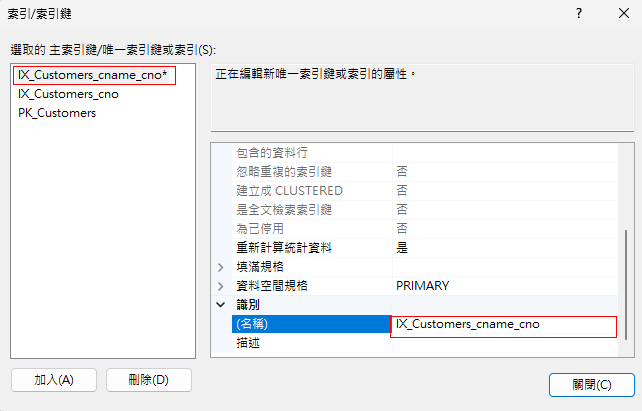
- 修改原名稱為
IX_Customers*為IX_Customers_cname_cno,解譯為以CustName先作查詢,碰到客戶名稱同名稱在找CustNo。
- 按下 加入 後會產生新索引鍵
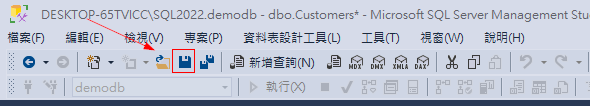
- 至此,建立好所有需要的索引,記得最後 存檔 不然不會改變資料表結構。
- 存檔後,關閉資料表
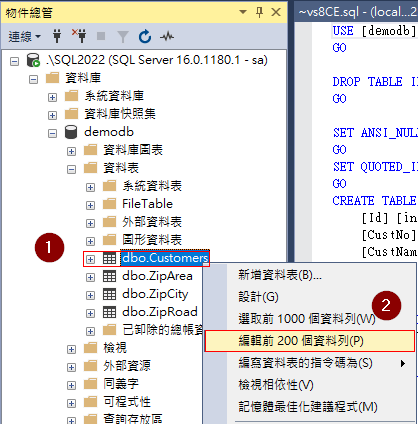
dbo.Customers設計畫面後,選取dbo.Customers後,滑鼠右鍵 編輯前 200 個資料列。
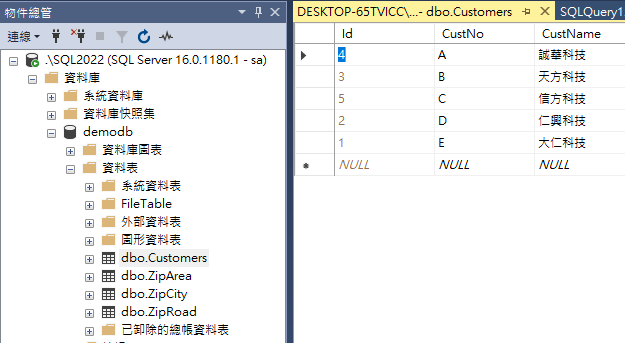
叢集索引(實際存在資料庫的排序)設在
Cust_No,沒特別設定排序查詢條件下,就是依照叢集索引的欄位來排序。 - 查詢索引的建置: 展開資料表
Customers後,在找到索引展開它。
一個主索引鍵、一個叢集、一個非叢集。
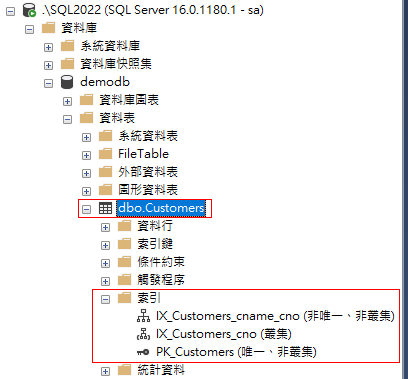
查詢
-
選取
demodb資料庫,滑鼠右鍵新增查詢,輸入以下指令:
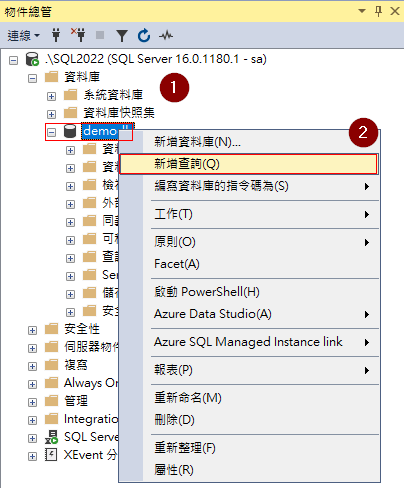
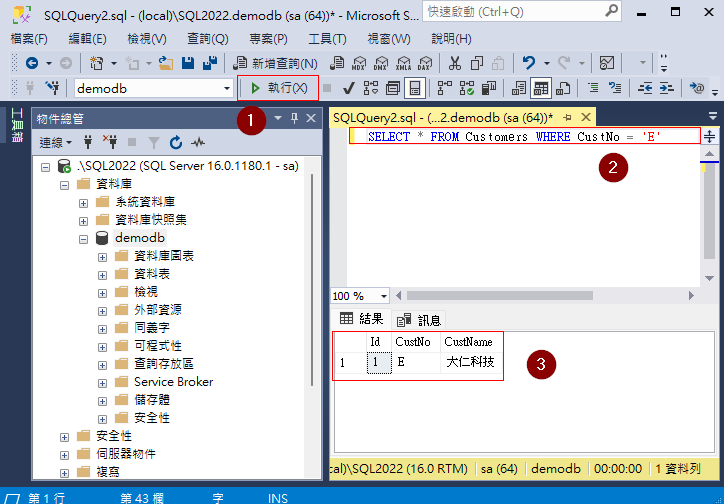
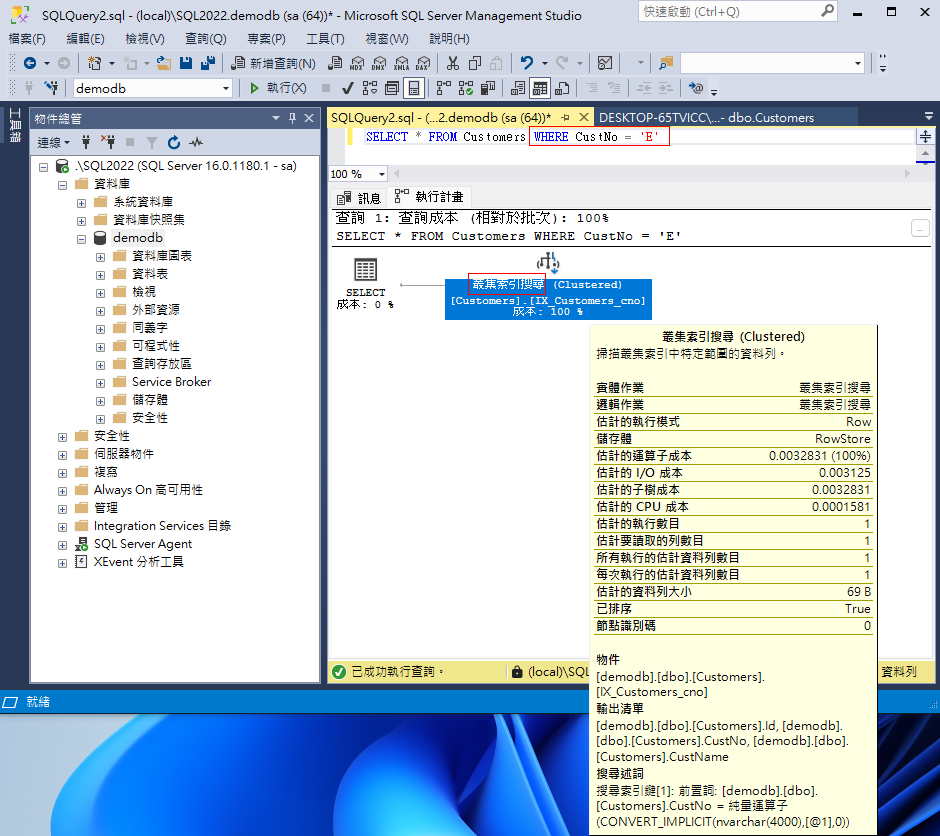
SELECT * FROM Customers WHERE CustNo = 'E' -
執行後,結果如下圖:
-
使用什麼樣的索引來作 SQL 查詢,可以點擊 顯示估計執行計劃 來觀看。
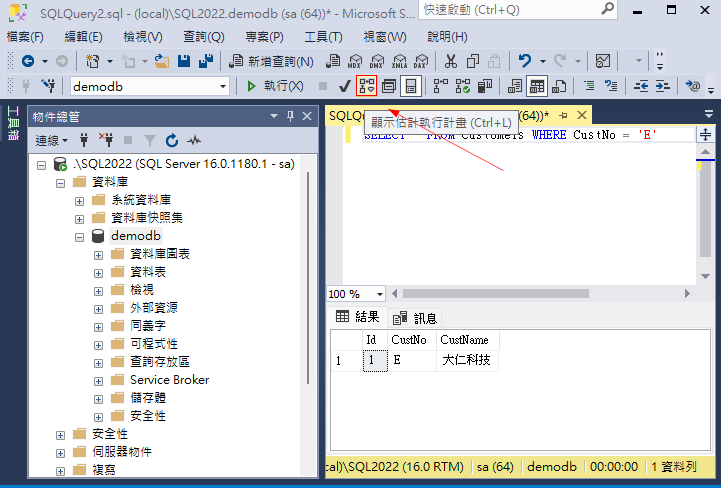
-
如下圖,得知查詢時是用最快速方法的叢集索引搜尋方法來作查詢。
-
將查詢條件換成用
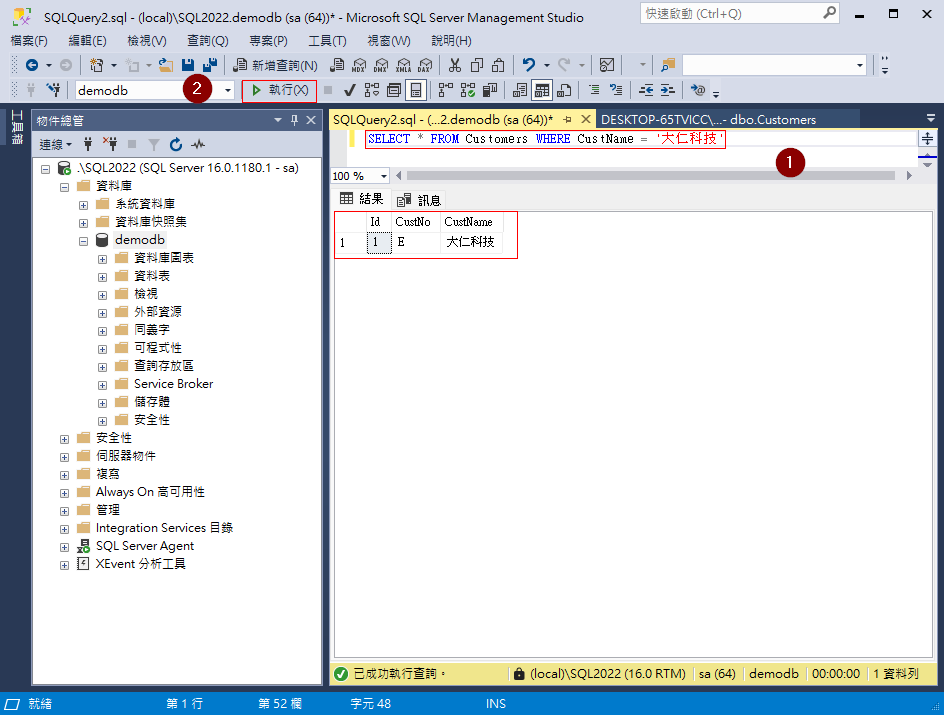
CustName來作查詢SELECT * FROM Customers WHERE CustName = '大仁科技' -
執行後,結果如下圖:
-
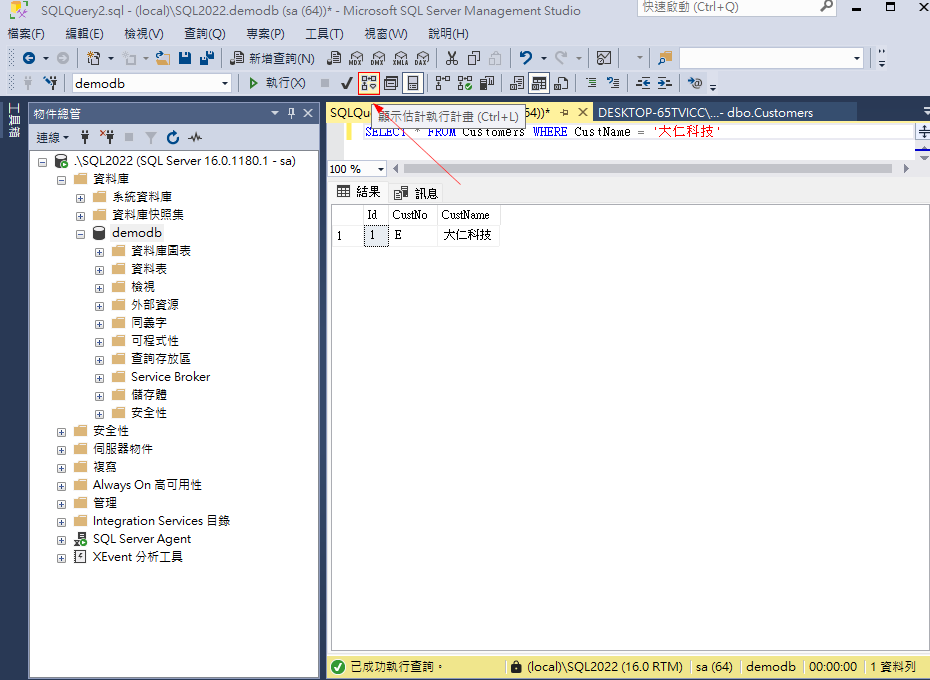
使用什麼樣的索引來作 SQL 查詢,可以點擊 顯示估計執行計劃 來觀看
-
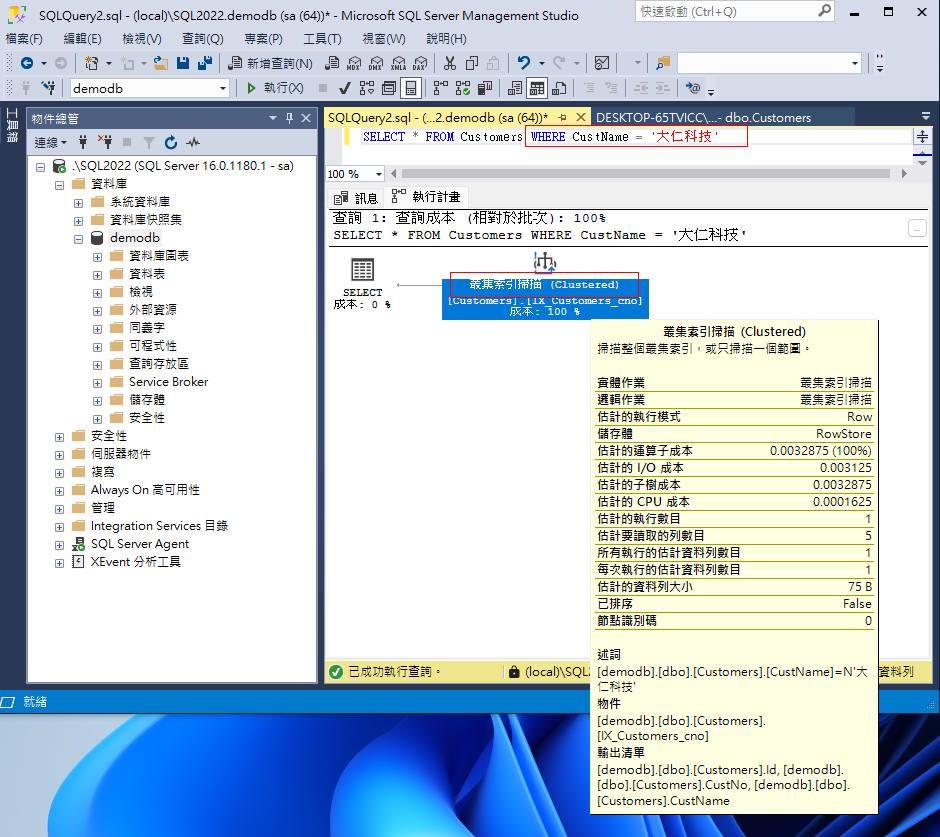
這次計劃顯示的結果是 叢集索引掃描
-
前面是 叢集索引搜尋,這次變成叢集索引掃描,若有其他新欄位也都會是叢集索引掃描。
-
新增欄位
Remark,加入 5 筆值 (F、S、K、T、E) -
輸入以下指令查詢
SELECT * FROM Customers WHERE Remark = 'E'新增欄位 SSMS 無法立即反應,從新開
SSMS即正常。
-
-
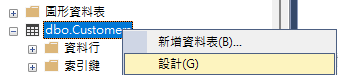
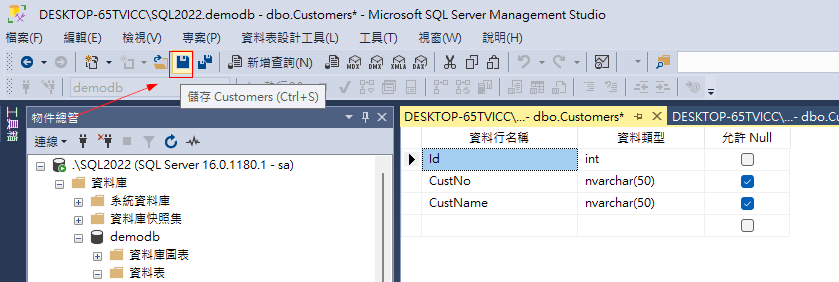
若移除
dbo.Customers所有索引。dbo.Customers滑鼠右鍵點擊設計
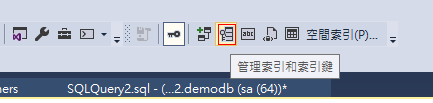
- 點擊 管理索引和索引建
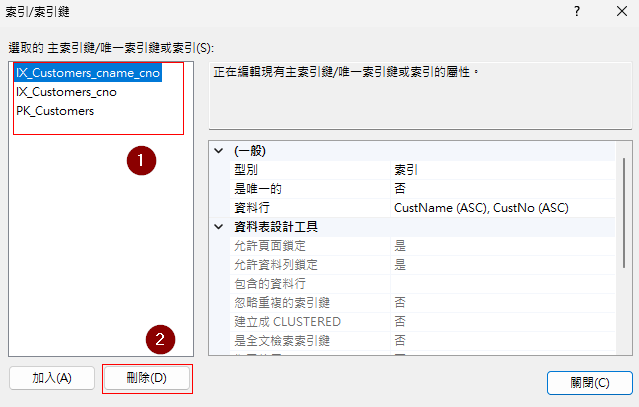
- 刪除所有索引建
- 存檔
-
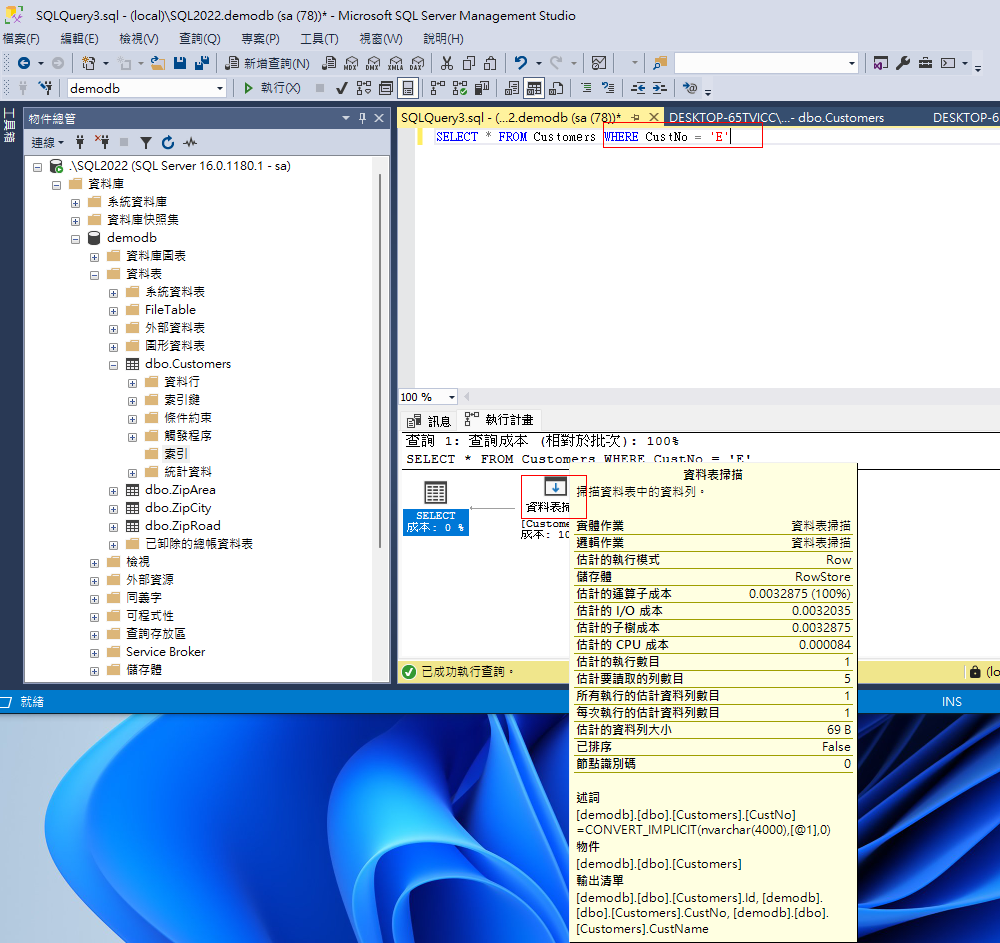
重新下達查詢指令
SELECT * FROM Customers WHERE CustNo = 'E' -
按下 顯示估計執行計劃
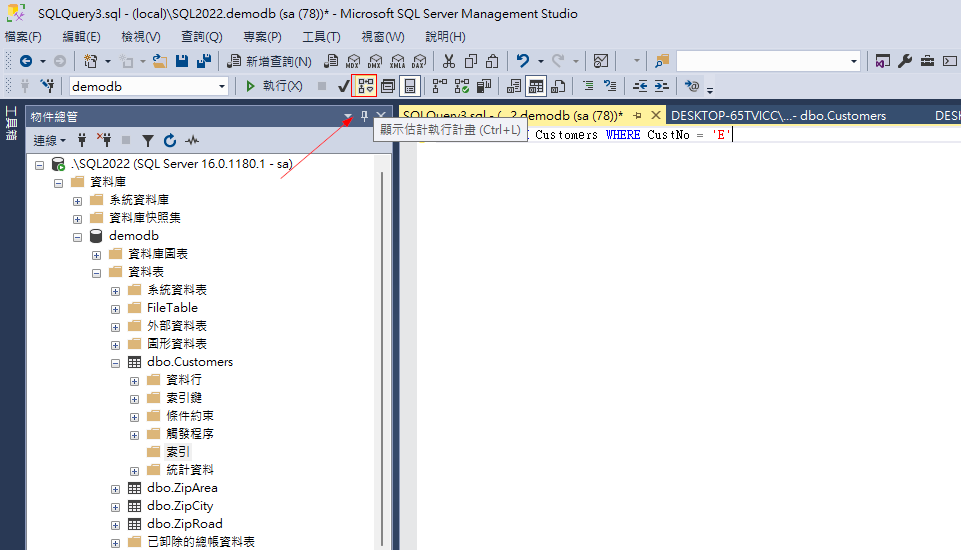
-
完全沒有用索引方式來作查詢。
-
復原
3. B-Tree 演算法
1.什麼是 B-Tree ?
B-Tree 是一種「平衡樹」的資料結構,用樹狀方式存放資料。
每個節點可以存好幾筆資料(不只1筆),樹會自動保持平衡,這樣查找、插入、刪除資料時,都能在很有效率的時間內完成。
為什麼它很重要?
- 減少磁碟 I/0次數
- 加快資料查詢速度
- 大量資料也能維持穩定效能
- 廣泛應用於資料庫與檔案系統
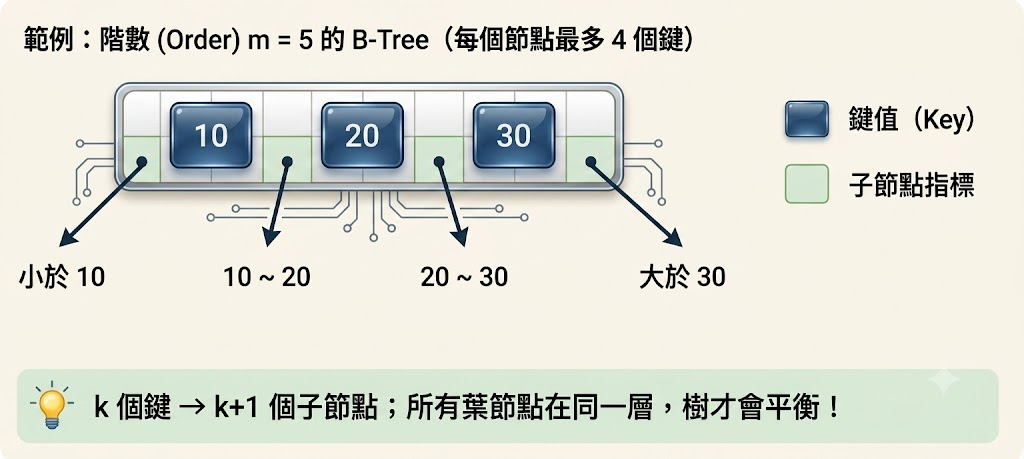
2.B-Tree 的結構規則:維持平衡與效率的基石
- 節點容量
- 除根節點外,每個節點至少包含「m/2」-1個鍵。
- 每個節節點最多包含m-1個鍵。
- 子節點數量
- 一個節點有k個鍵,就會有k+1個子節點。
- 絕對平衡
- 所有葉節點點都在同一層級,確保查詢效率一致。
- 内部排序
- 節點內的鍵從小到大排序,子節點的值介於相鄰值之間。
3.B-Tree 的設計哲學:用寬度换取高度
B-Tree 的每個點可以存多個鍵值(Keys),讓樹變「又矮又胖」,大幅降低樹的高度,減少磁蝶 IO 次數,查詢更快!
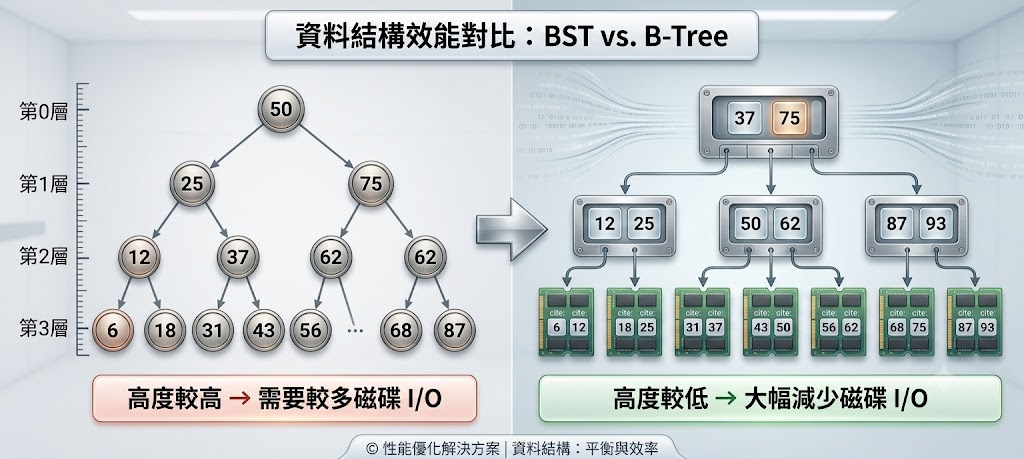
好處
- 查詢更快: 樹高降低,查找節點次數少
- 磁碟1/0 減少: 每次存取可讀取更多資料
- 效能穩定: 自動平衡,不會樹歪
- 適合大資料量: 資料越多,優勢越明顯
B-Tree的應用場景
主要應用於需要大量資料儲存與快速查詢的系統,尤其是依賴磁碟存取的環境。
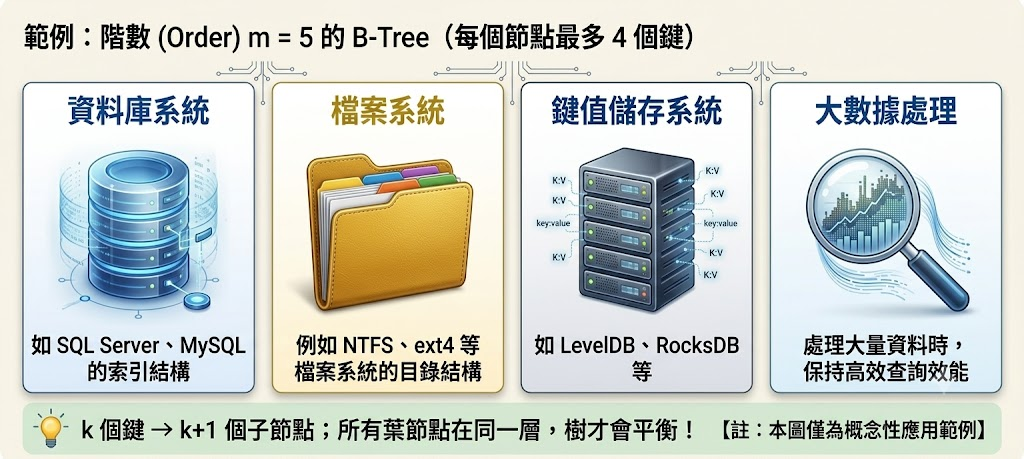
核心價值
透過「多鍵值」與「平衡結構」,讓B-Tree在大量資料時,依然能快速、穩定地完成查詢與更新!
4. 叢集/非叢集索引
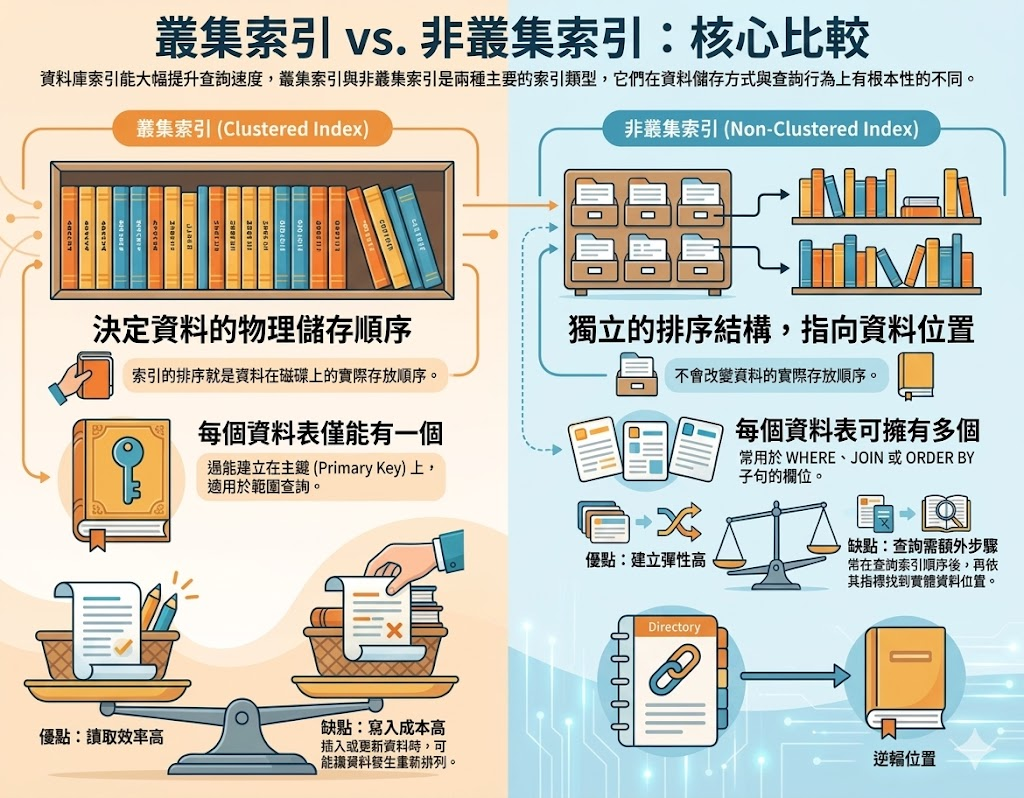
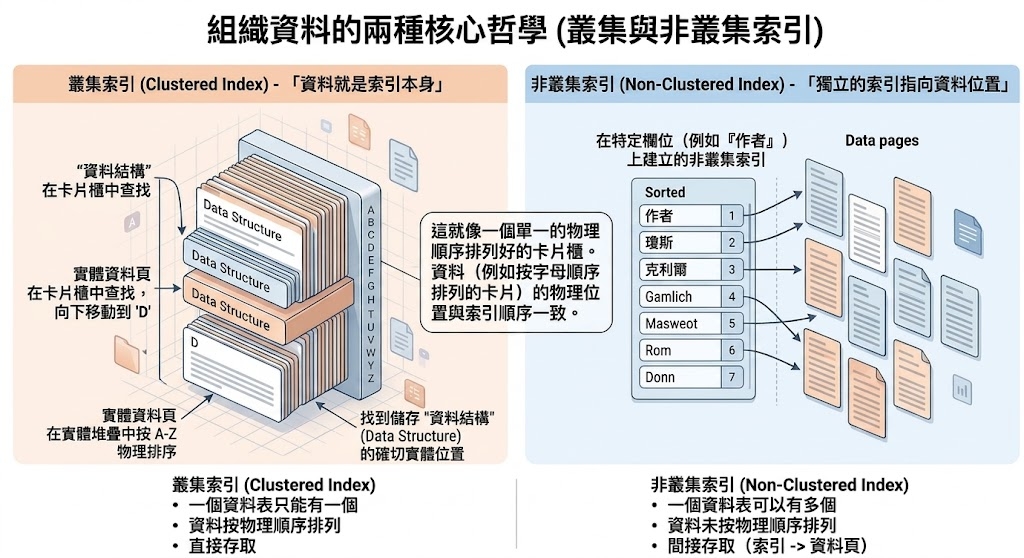
4.1 叢集 vs 非叢集索引
4.2 叢集索引(Clustered Index)
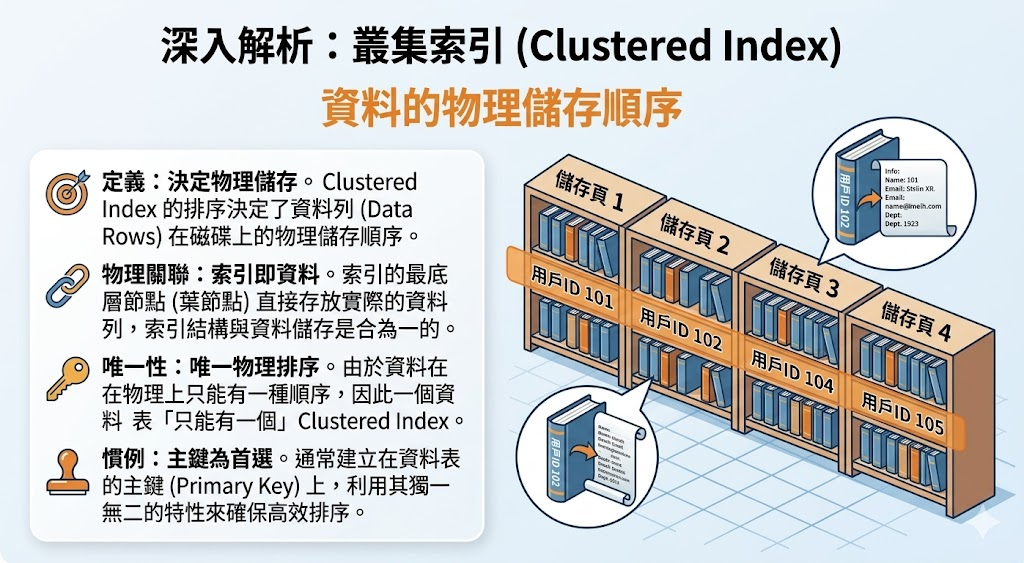
我們可以將「叢集索引(Clustered Index)」想像成一本內容已經按照「部首」排列好的紙本字典。
這種索引的核心設計在於,索引的順序就決定了資料在磁碟上實際存放的物理順序。它的特點如下:
-
索引與資料一體:在叢集索引中,索引的最底層(葉節點)直接存放的就是實際的資料內容,索引與資料是合而為一的。就像字典裡的字是實際按部首順序印在紙上,資料本身就是排序好的。
-
唯一性:因為它決定了資料的實體儲存順序,所以一個資料表只能有一個叢集索引。就像字典只能有一種物理排序方式,如果按照部首排列,就不能同時也按注音物理排列。
-
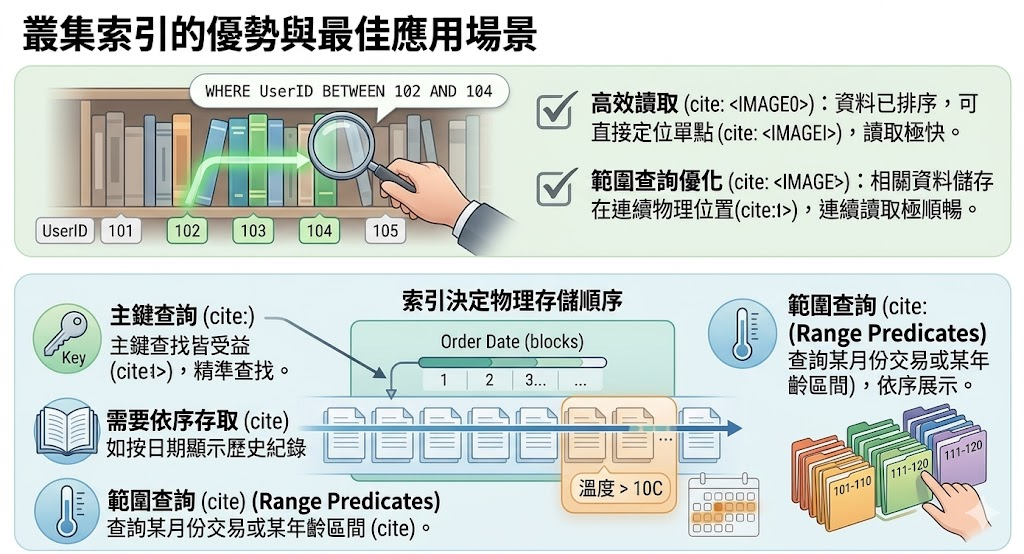
優點:讀取高效率:由於資料實體地存放在一起,進行「範圍查詢」時效率極高。例如要尋找所有「木」部的字,只需要定位到起點後,連續向後讀取即可。
-
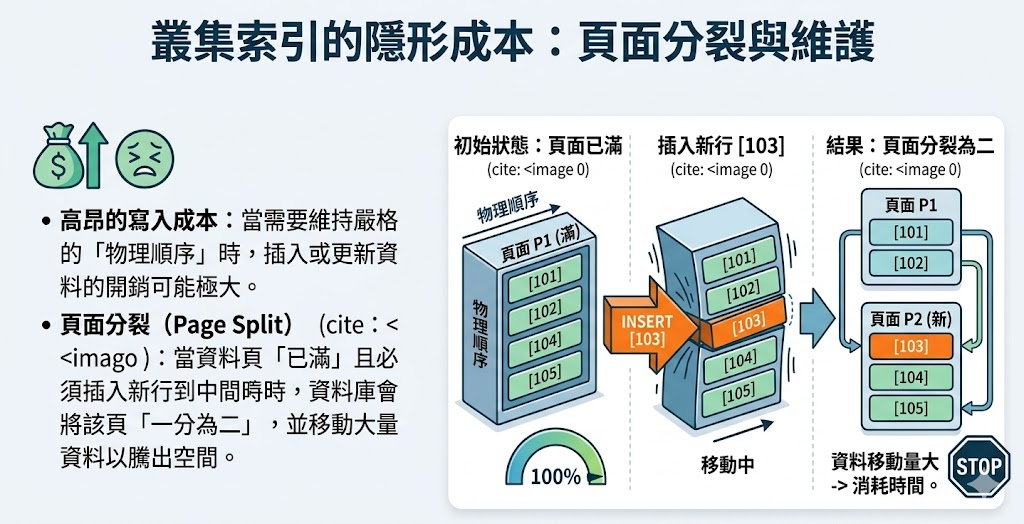
缺點:寫入成本高:當新增或修改資料時,可能需要重新排列大量資料。若要在頁面中間插入新資料,可能需將其後所有資料向後移動,導致效能開銷較大。
當資料表設立 Primary key 時,SQL Server 通常會自動建立叢集索引。
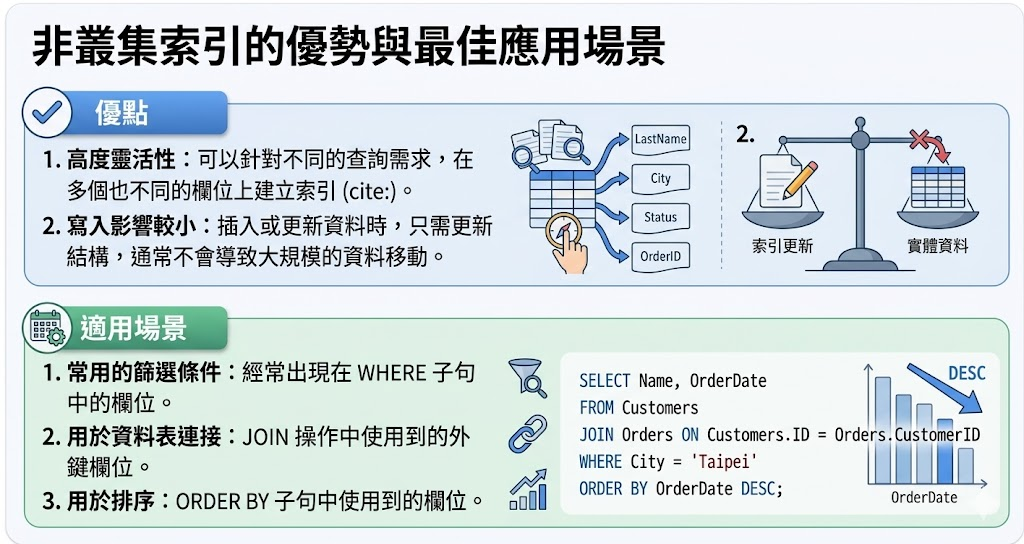
4.3 非叢集索引(NonClustered Index)
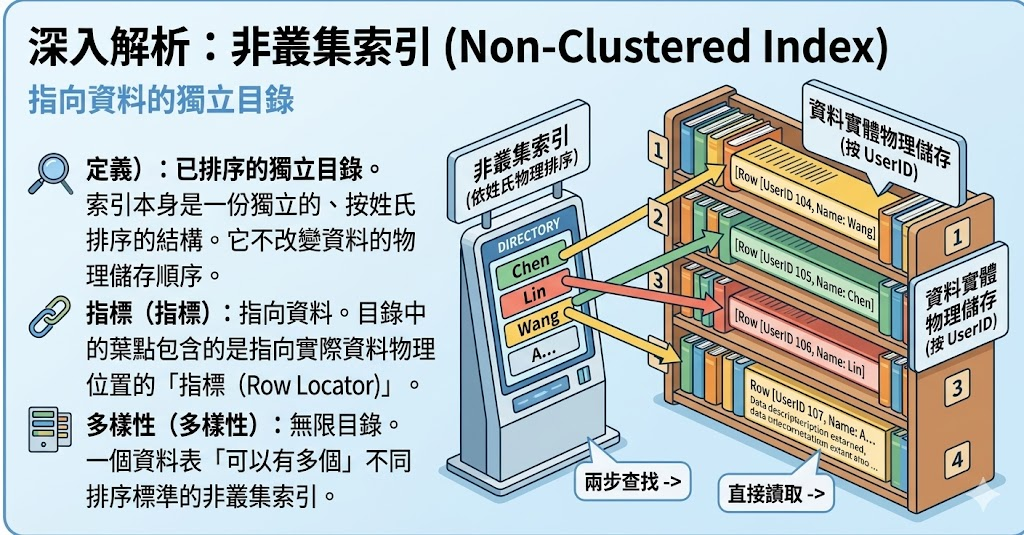
我們可以將「非叢集索引(Non-Clustered Index)」想像成技術書籍或教科書背後的「書末關鍵字索引」。
這種索引的核心設計在於「索引與內容分離,透過頁碼(指標)做連結」,它的特點如下:
-
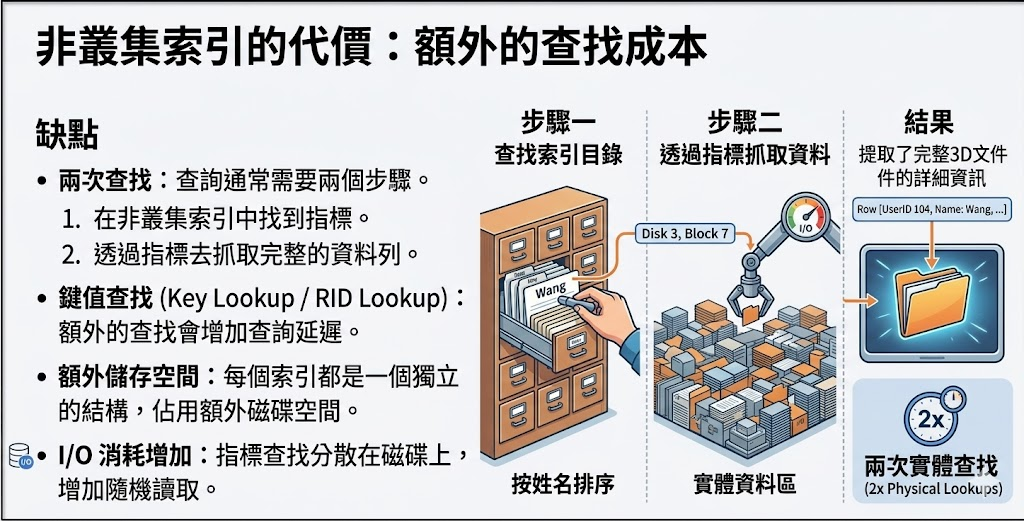
獨立的排序結構:書末的關鍵字索引是一份完全獨立的清單,按照字母或筆劃排好。書本內文的章節順序,並不會因為這份索引而改變。在資料庫中,非叢集索引的底層(葉節點)存放的不是資料本身,而是指向實際資料物理位置的「指標(Row Locator)」。
-
優點:彈性多元(一表可有多個):就像一本書除了有「關鍵字索引」,還可以同時擁有「人名索引」或「地名索引」一樣。因為它不改動內文順序,所以一個資料表可以建立多個非叢集索引。你可以針對常用的查詢條件(如
WHERE、JOIN或ORDER BY的欄位)各自建立專屬索引,大幅提升查詢彈性。 -
缺點:需要「兩步查找」:使用這種索引查資料時,需要多一個步驟。你必須先在書末索引找到關鍵字(第一步:查索引),再根據後面的頁碼翻到內文去讀取實際內容(第二步:看內文)。這個翻頁尋找實際資料的額外步驟,在資料庫術語中被稱為 Key Lookup(或 RID Lookup)。
💡 快速總結:一分鐘看懂兩者差異
| 特性 | 叢集索引 (Clustered) | 非叢集索引 (Non-Clustered) |
|---|---|---|
| 比喻 | 字典(字本身就是排好的) | 書本目錄/書末索引(另外獨立一頁) |
| 資料物理順序 | 決定資料在磁碟上的物理排序 | 不影響資料在磁碟上的物理排序 |
| 索引底層存什麼 | 實際的資料內容(索引即資料) | 指向資料位置的指標(類似頁碼) |
| 一個資料表能有幾個 | 只能有 1 個 | 可以有多個 |
| 查詢特點 | 範圍查詢極快 | 查詢需要多一個「看頁碼找資料」的步驟 |
4.4 核心差異總整理
透過下表,我們可以一目了然地看到兩者在設計理念與應用上的根本差異。
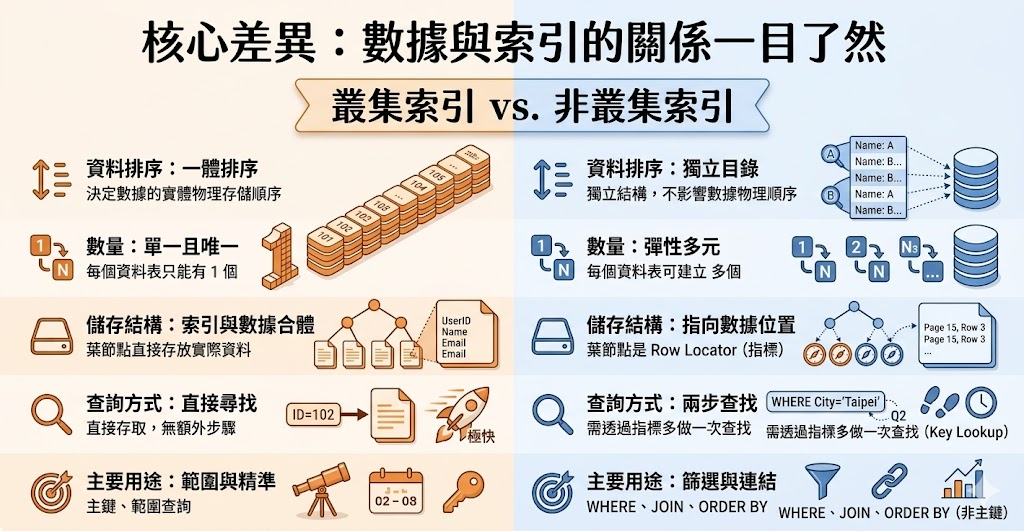
透過這個表格,我們可以清楚看到,選擇哪種索引取決於我們如何看待資料的「組織」與「查找」。
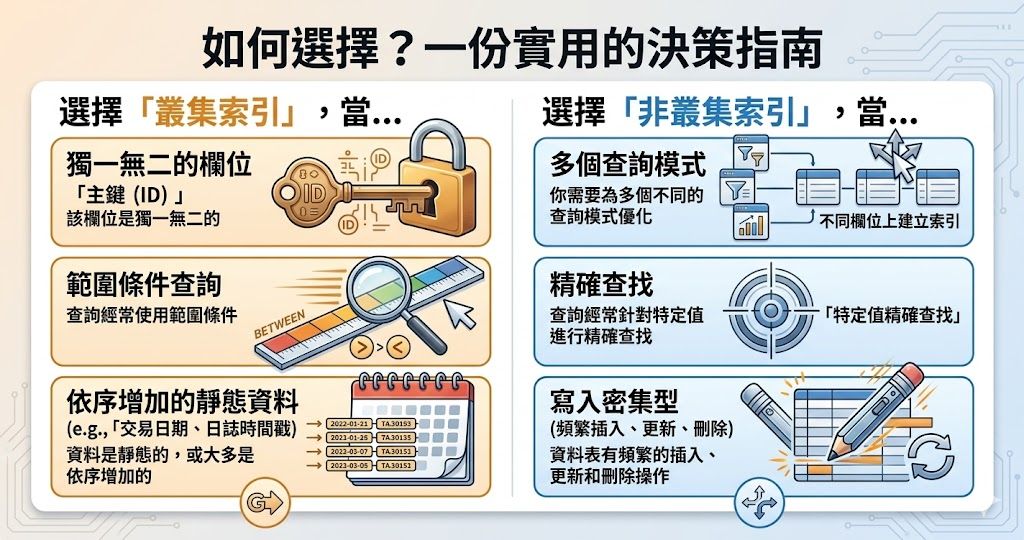
4.5 如何選擇
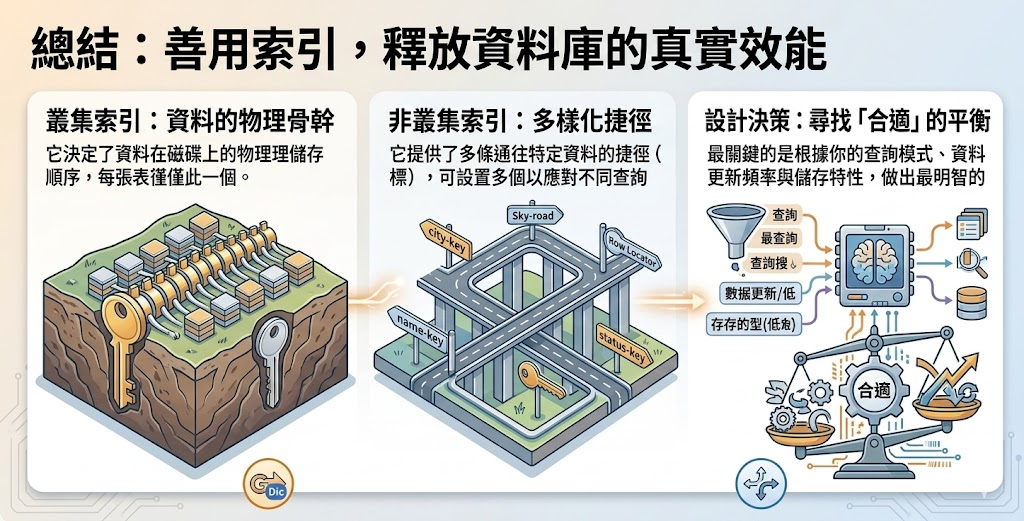
4.6 總結
5 實作建立索引
5.1 建立以 CustNo 為排序條件的非叢集索引
目前的 Customers 資料表有建立 主鍵叢集索引 (Clustered Index):
PK_Customers (Id)一個資料表只能有一個叢集索引。
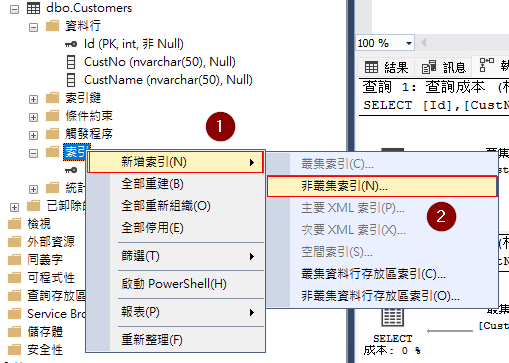
步驟 1
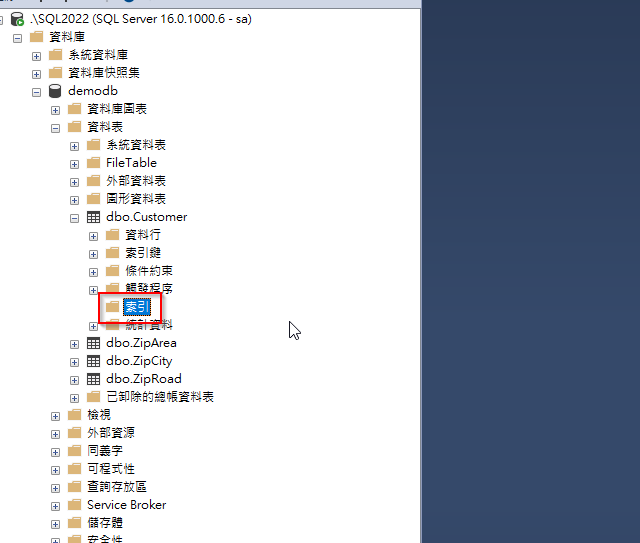
展開:
資料表
└ dbo.Customers
   └ 索引
右鍵:
索引→ 新增索引→ 非叢集索引...
步驟 2
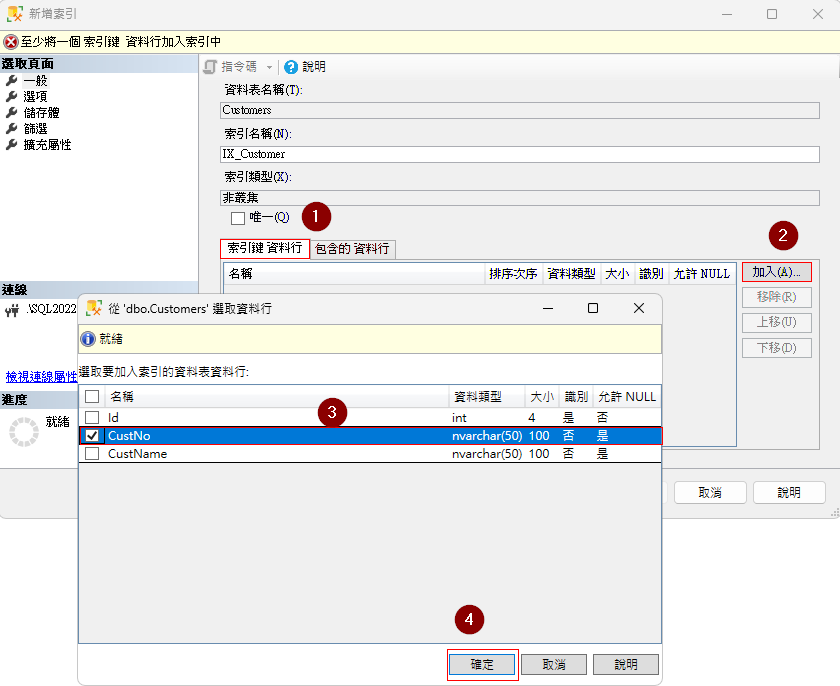
索引名稱輸入:
IX_Customer
步驟 3
在索引鍵資料行按:
加入(A)...
選擇:
CustNo
排序:
選取 CustNo 後按【確定】,回到上一個「新增索引」畫面,點擊欄位: 排序次序,選擇遞增 後按下 確定。
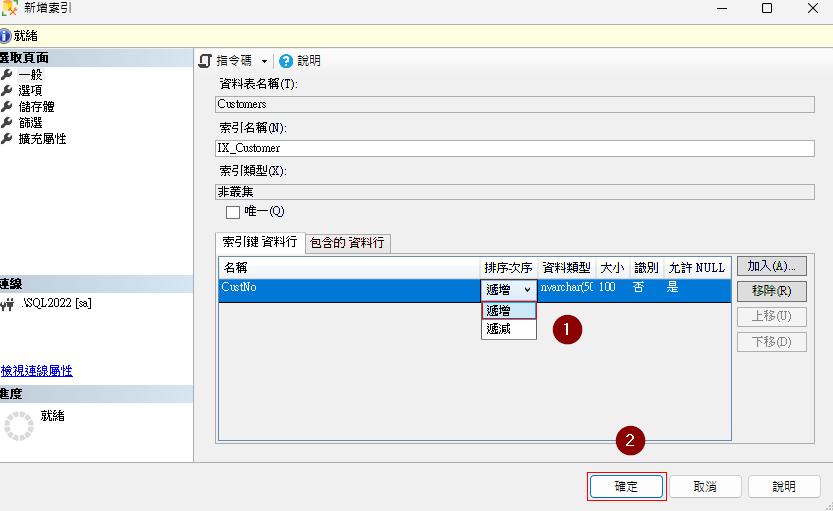
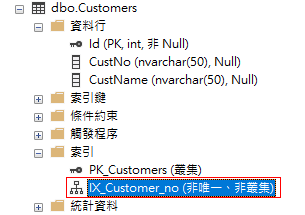
修改名稱 IX_Customer 為 IX_Customer_no
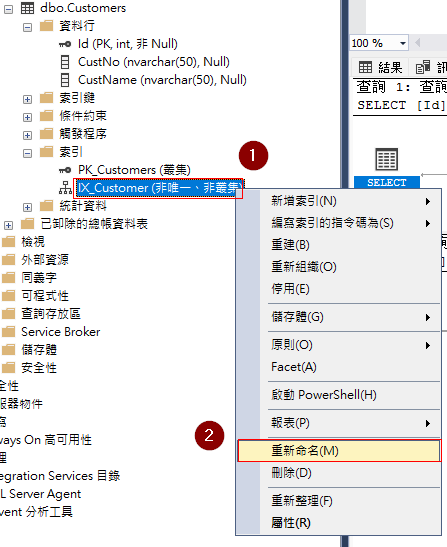
結果:
5.2 建立以 CustName 為排序條件的叢集索引
步驟 1
展開:
資料表
└ dbo.Customers
   └ 索引
右鍵:
索引→ 新增索引→ 非叢集索引...
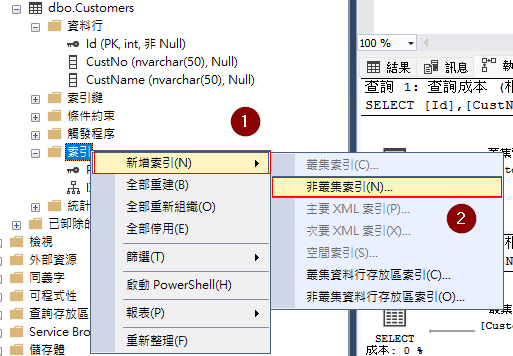
步驟 2
索引名稱輸入:
IX_Customer
步驟 3
在索引鍵資料行按:
加入(A)...
選擇:
CustName
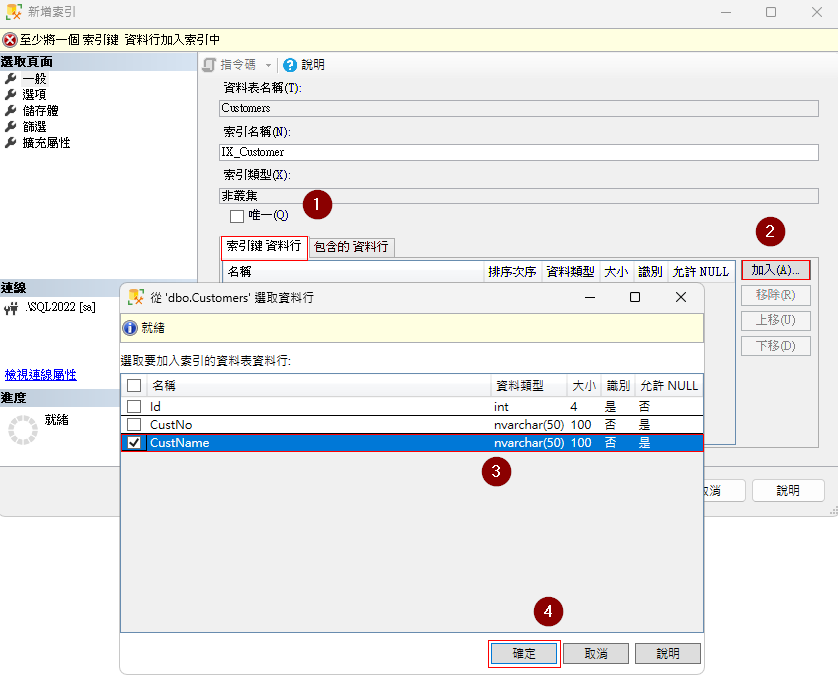
排序:
選取 CustName後按【確定】,回到上一個「新增索引」畫面,點擊欄位: 排序次序,選擇遞增 後按下 確定。
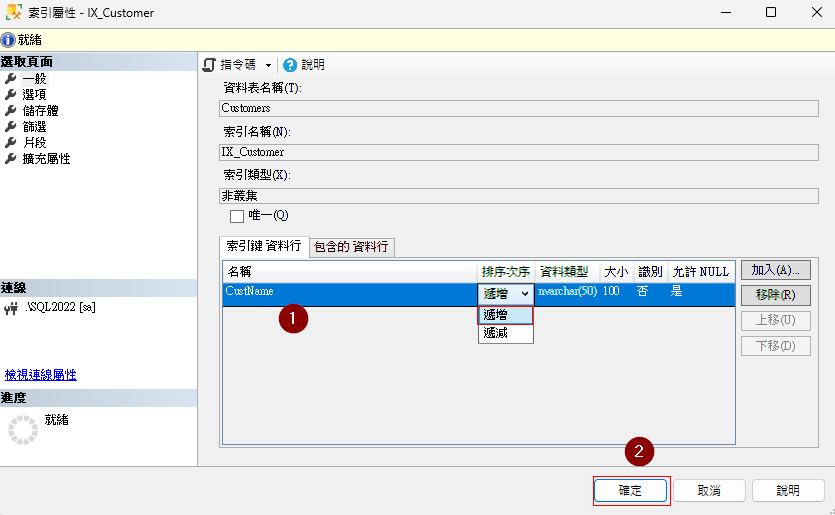
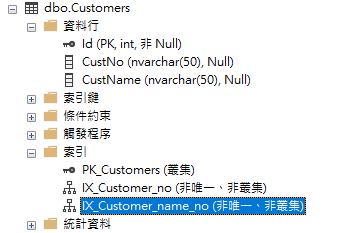
修改名稱IX_Customer為IX_Customer_name_no
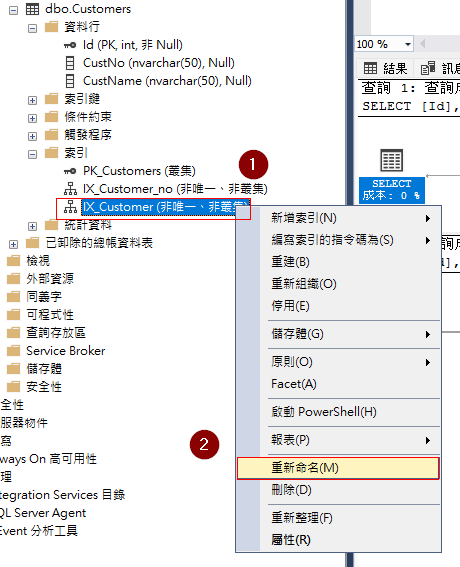
結果:
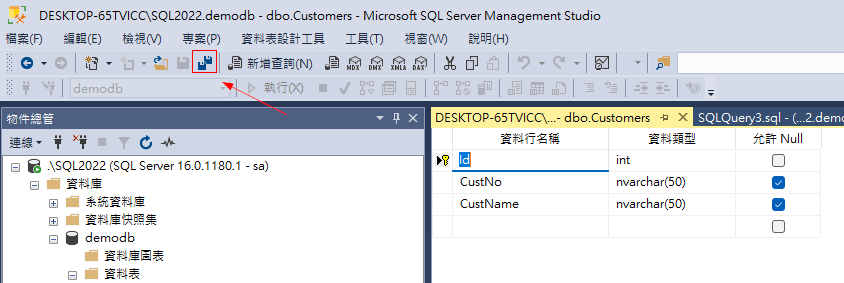
5.3 存檔
執行結果
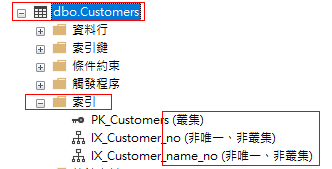
5.4 查詢索引明細
執行結果
5.5 檢查使用索引狀況
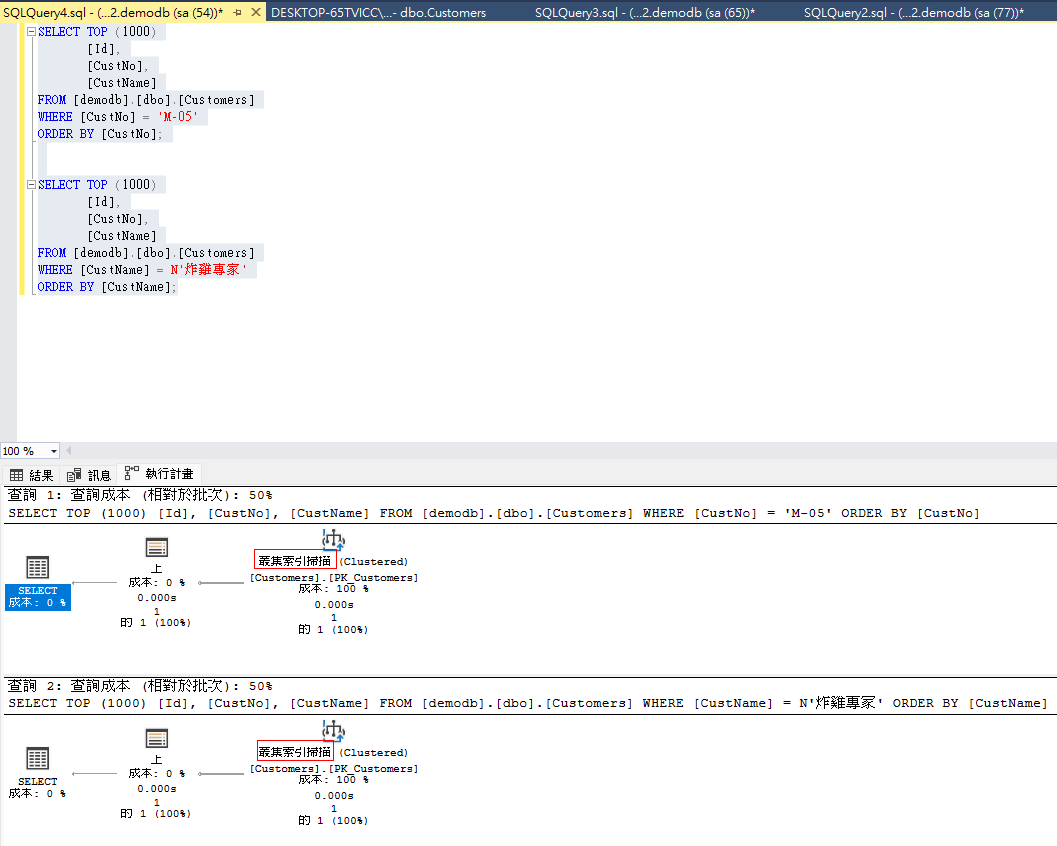
SELECT TOP (1000)
       [Id],
       [CustNo],
       [CustName]
FROM [demodb].[dbo].[Customers]
WHERE [CustNo] = 'M-05'
ORDER BY [CustNo];


SELECT TOP (1000)
       [Id],
       [CustNo],
       [CustName]
FROM [demodb].[dbo].[Customers]
WHERE [CustName] = N'炸雞專家'
ORDER BY [CustName];
執行結果
不能開啟資料表檢視設計模式
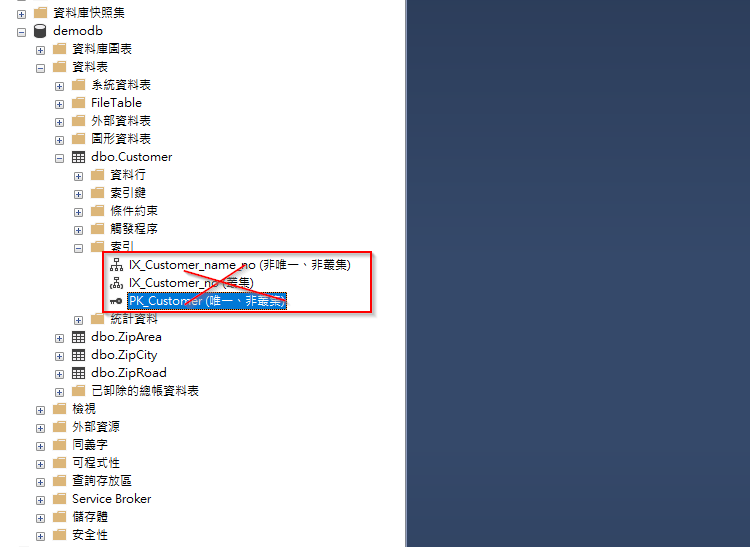
5.6 刪除所有索引
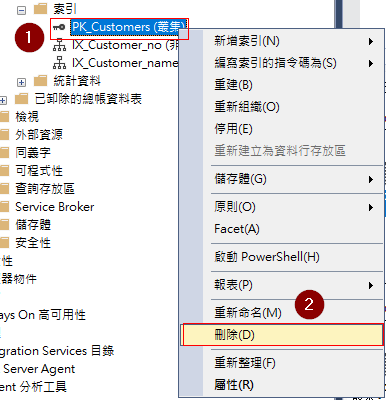
執行結果
5.5 檢查使用索引狀況
執行結果